2026
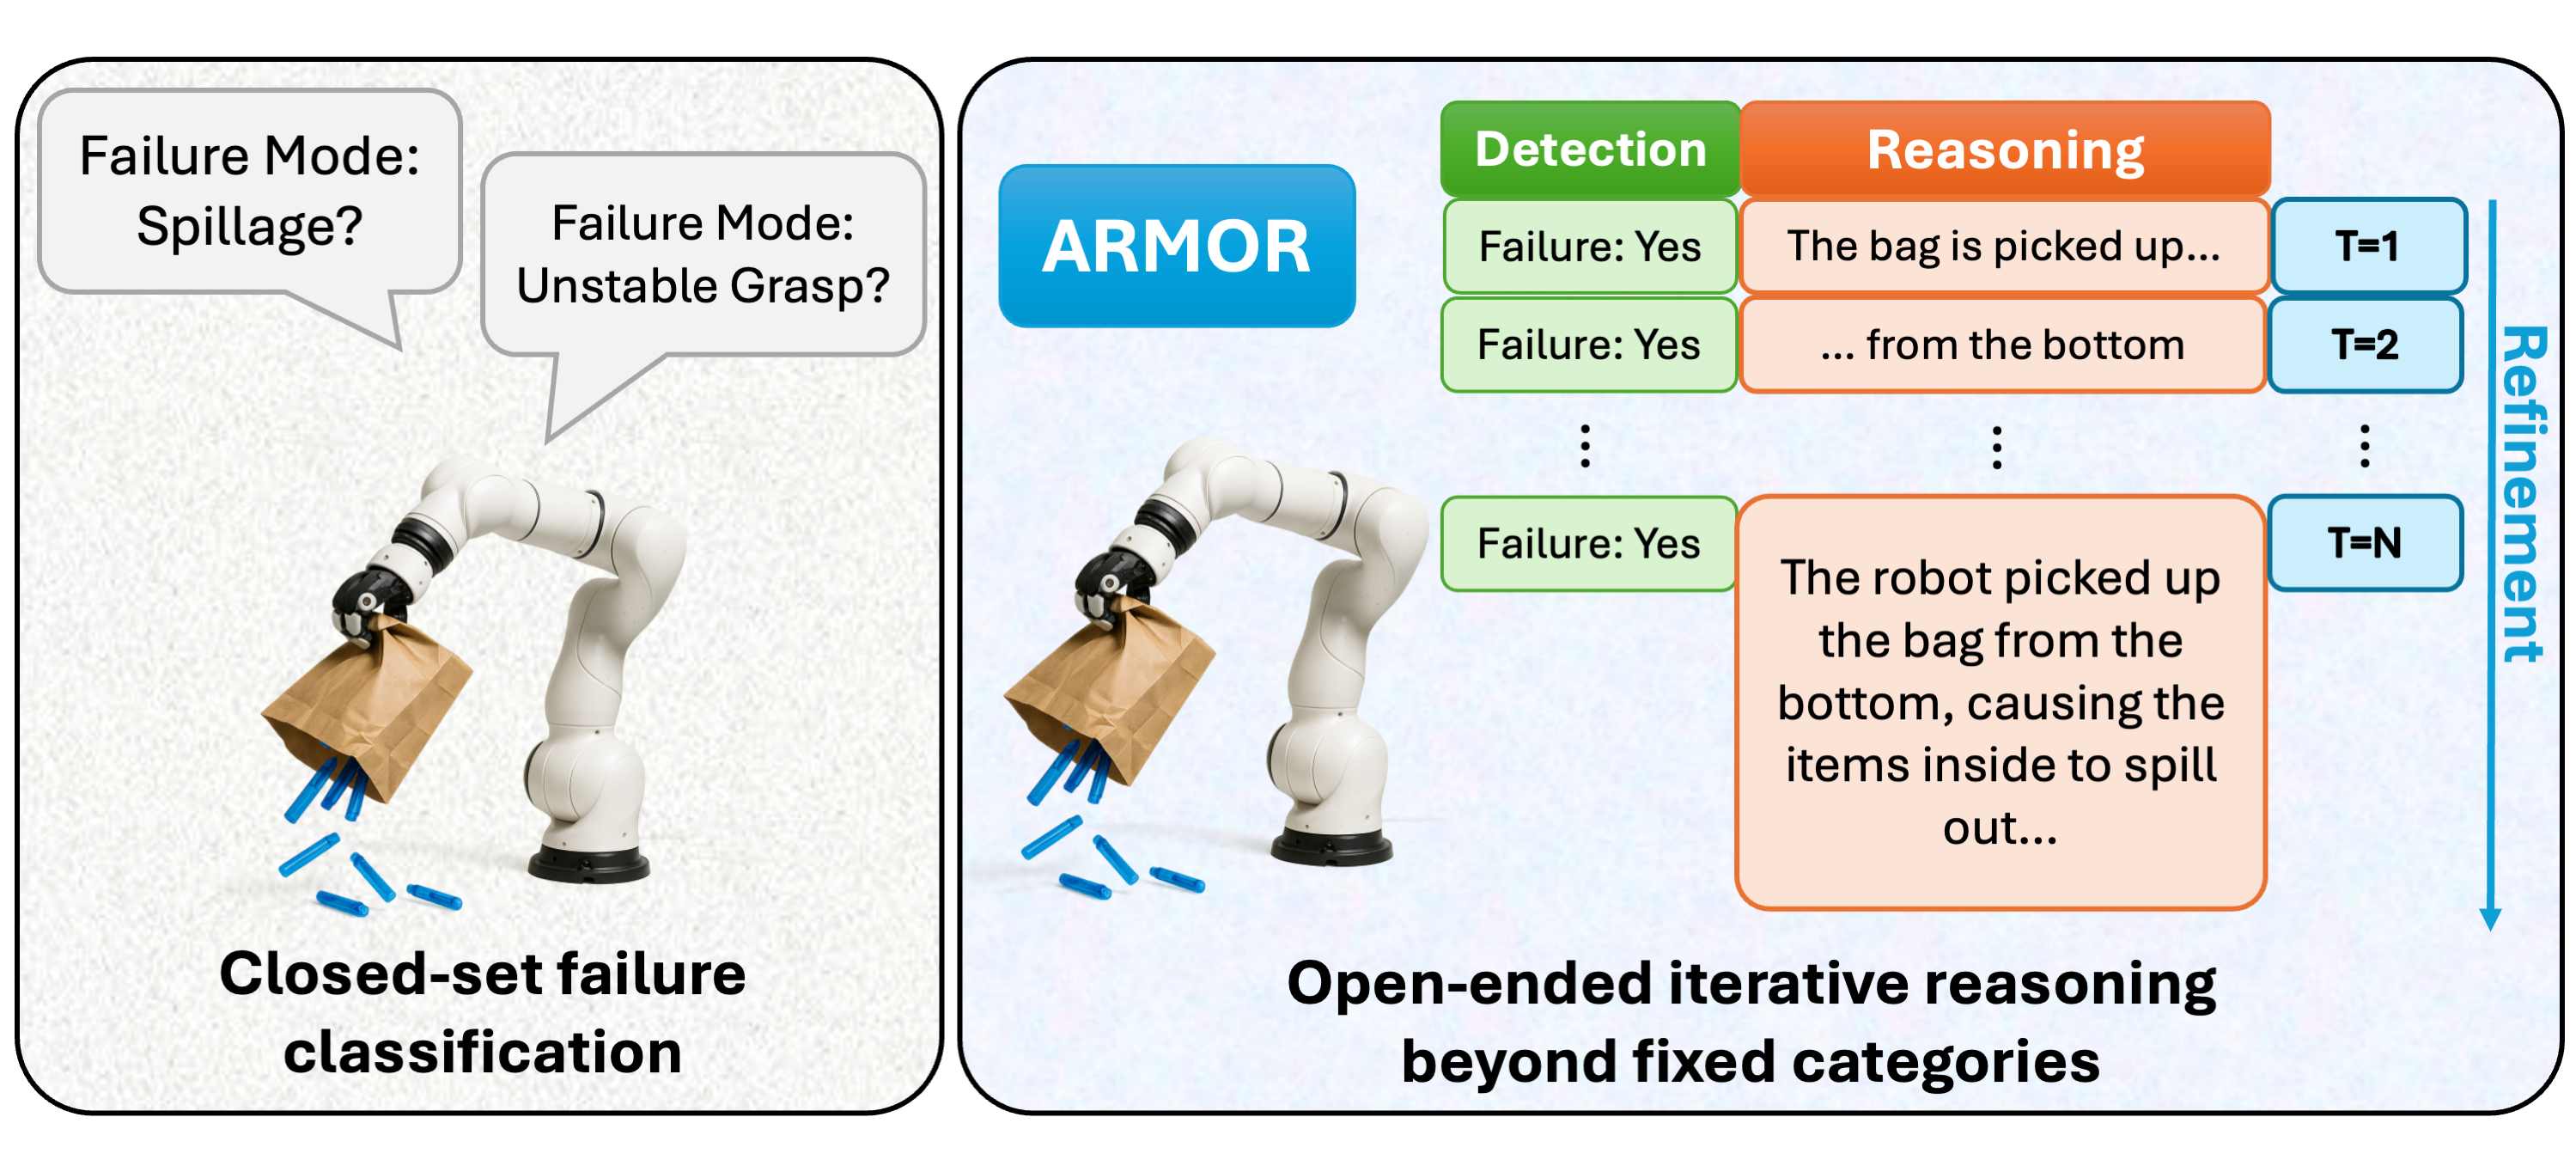
Self-Refining Vision Language Model for Robotic Failure Detection and Reasoning
Carl Qi, Xiaojie Wang, Silong Yong, Stephen Sheng, Huitan Mao, Sriram Srinivasan, Manikantan Nambi, Amy Zhang, Yesh Dattatreya
ICLR 2026
|
project page
 Reinforcement Learning via Value Gradient Flow
Haoran Xu, Kaiwen Hu, Somayeh Sojoudi, Amy Zhang
ICLR 2026
|
arXiv
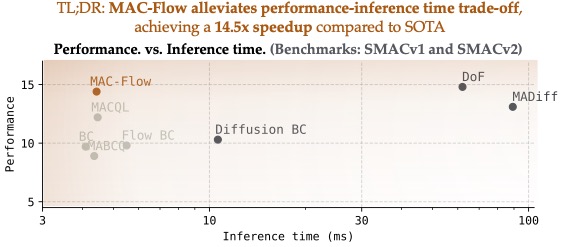
Multi-agent Coordination via Flow Matching
Dongsu Lee, Daehee Lee, Amy Zhang
ICLR 2026
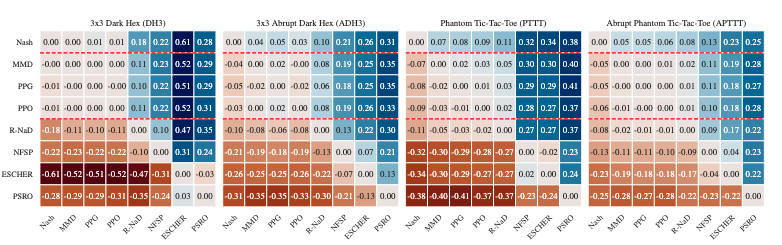
 Reevaluating Policy Gradient Methods for Imperfect-Information Games
Max Rudolph, Nathan Lichtle, Sobhan Mohammadpour, Alexandre Bayen, J. Zico Kolter, Amy Zhang, Eugene Vinitsky, Sam Sokota
ICLR 2026
|
project page
2025
Uni-RL: Unifying Online and Offline RL via Implicit Value Regularization
Haoran Xu, Liyuan Mao, Hui Jin, Weinan Zhang, Xianyuan Zhan, Amy Zhang
NeurIPS 2025
Information-Theoretic Reward Decomposition for Generalizable RLHF
Liyuan Mao, Haoran Xu, Amy Zhang, Weinan Zhang, Chenjia Bai
NeurIPS 2025
|
arXiv
Unifying Agent Interaction and World Information for Multi-agent Coordination
Dongsu Lee, Daehee Lee, Yaru Niu, Honguk Woo, Amy Zhang, Ding Zhao
NeurIPS ARLET Workshop 2025 (Oral)
Offline Action-Free Learning of Ex-BMDPs by Comparing Diverse Datasets
Alexander Levine, Peter Stone, Amy Zhang
RLC 2025
 Fast Adaptation with Behavioral Foundation Models
Harshit Sikchi, Andrea Tirinzoni, Ahmed Touati, Yingchen Xu, Anssi Kanervisto, Scott Niekum, Amy Zhang, Alessandro Lazaric, Matteo Pirotta
RLC 2025
|
arXiv
Proto Successor Measure: Representing the Behavior Space of an RL Agent
Siddhant Agarwal, Harshit Sikchi, Peter Stone, Amy Zhang
ICML 2025
|
arXiv
CRESTE: Scalable Mapless Navigation with Internet Scale Priors and Counterfactual Guidance
Arthur Zhang, Harshit Sikchi, Amy Zhang, Joydeep Biswas
RSS 2025
|
project page
An Optimal Discriminator Weighted Imitation Perspective for Reinforcement Learning
Haoran Xu, Shuozhe Li, Harshit Sikchi, Scott Niekum, Amy Zhang
ICLR 2025
|
project page
 Learning a Fast Mixing Exogenous Block MDP using a Single Trajectory
Alexander Levine, Peter Stone, Amy Zhang
ICLR 2025
|
code
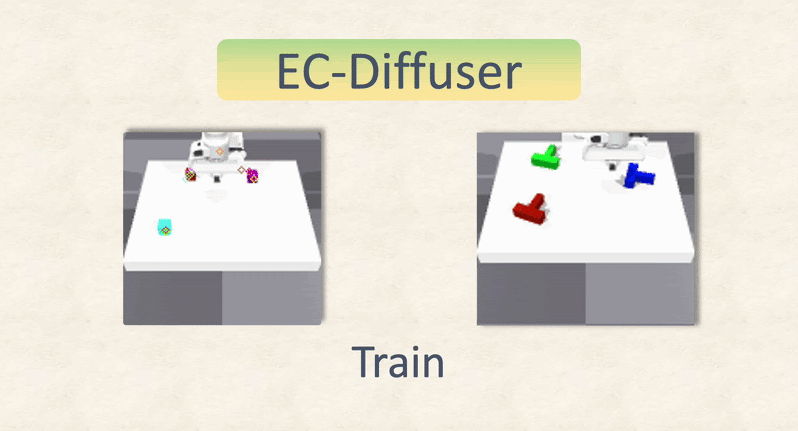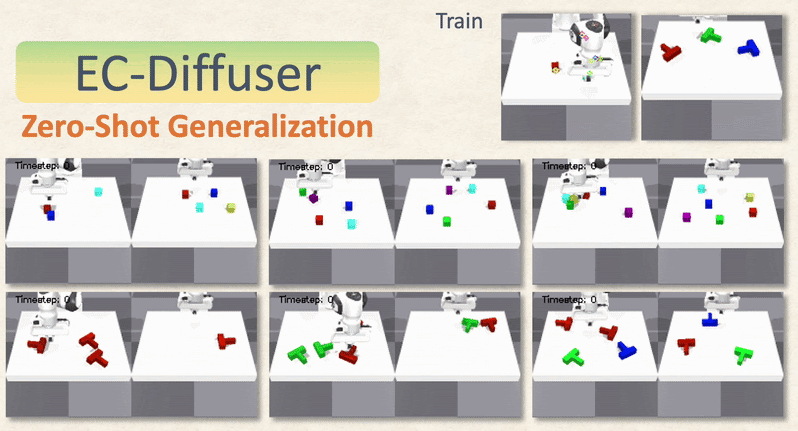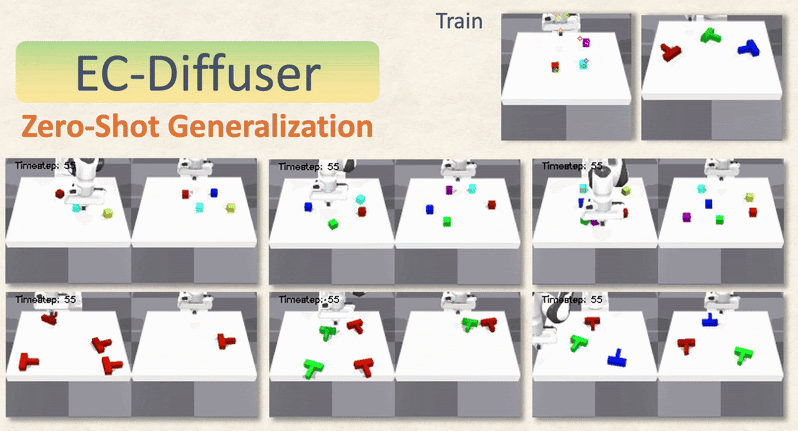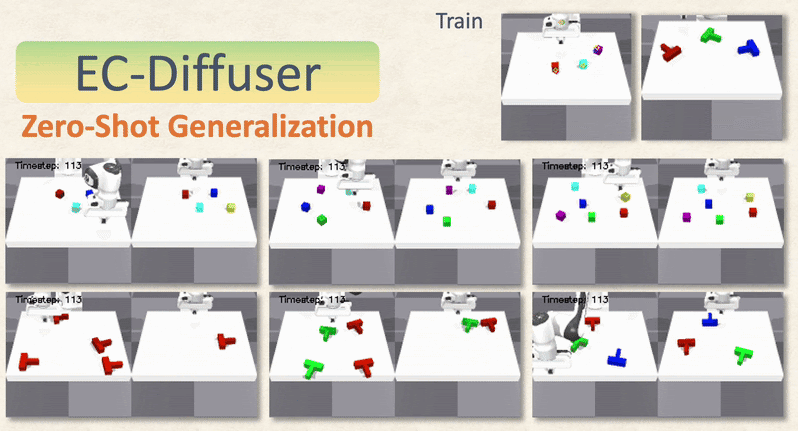
 EC-Diffuser: Multi-Object Manipulation via Entity-Centric Behavior Generation
Carl Qi, Dan Haramati, Tal Daniel, Aviv Tamar, Amy Zhang
ICLR 2025
|
project page
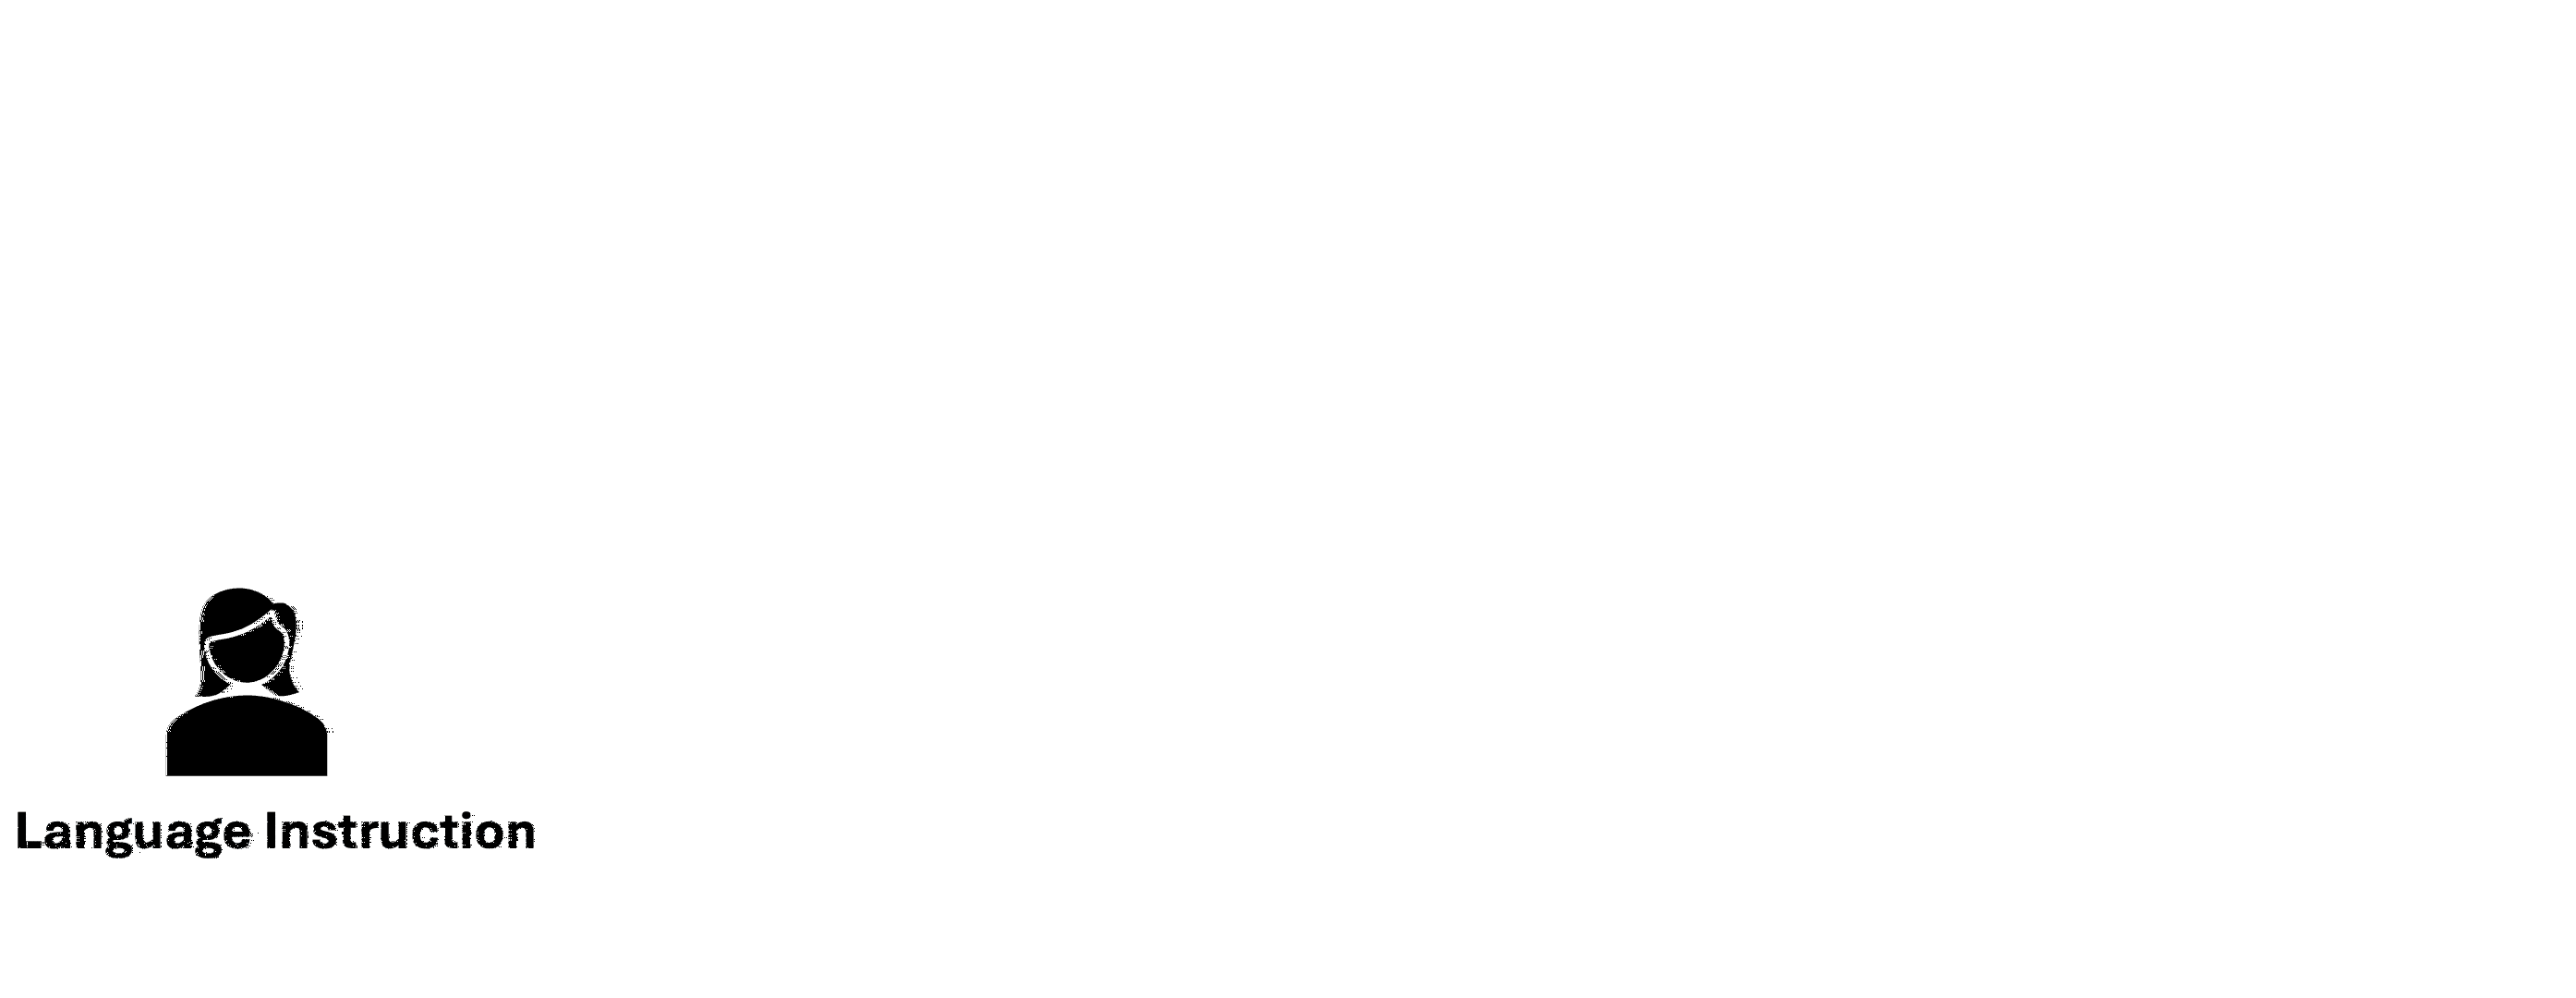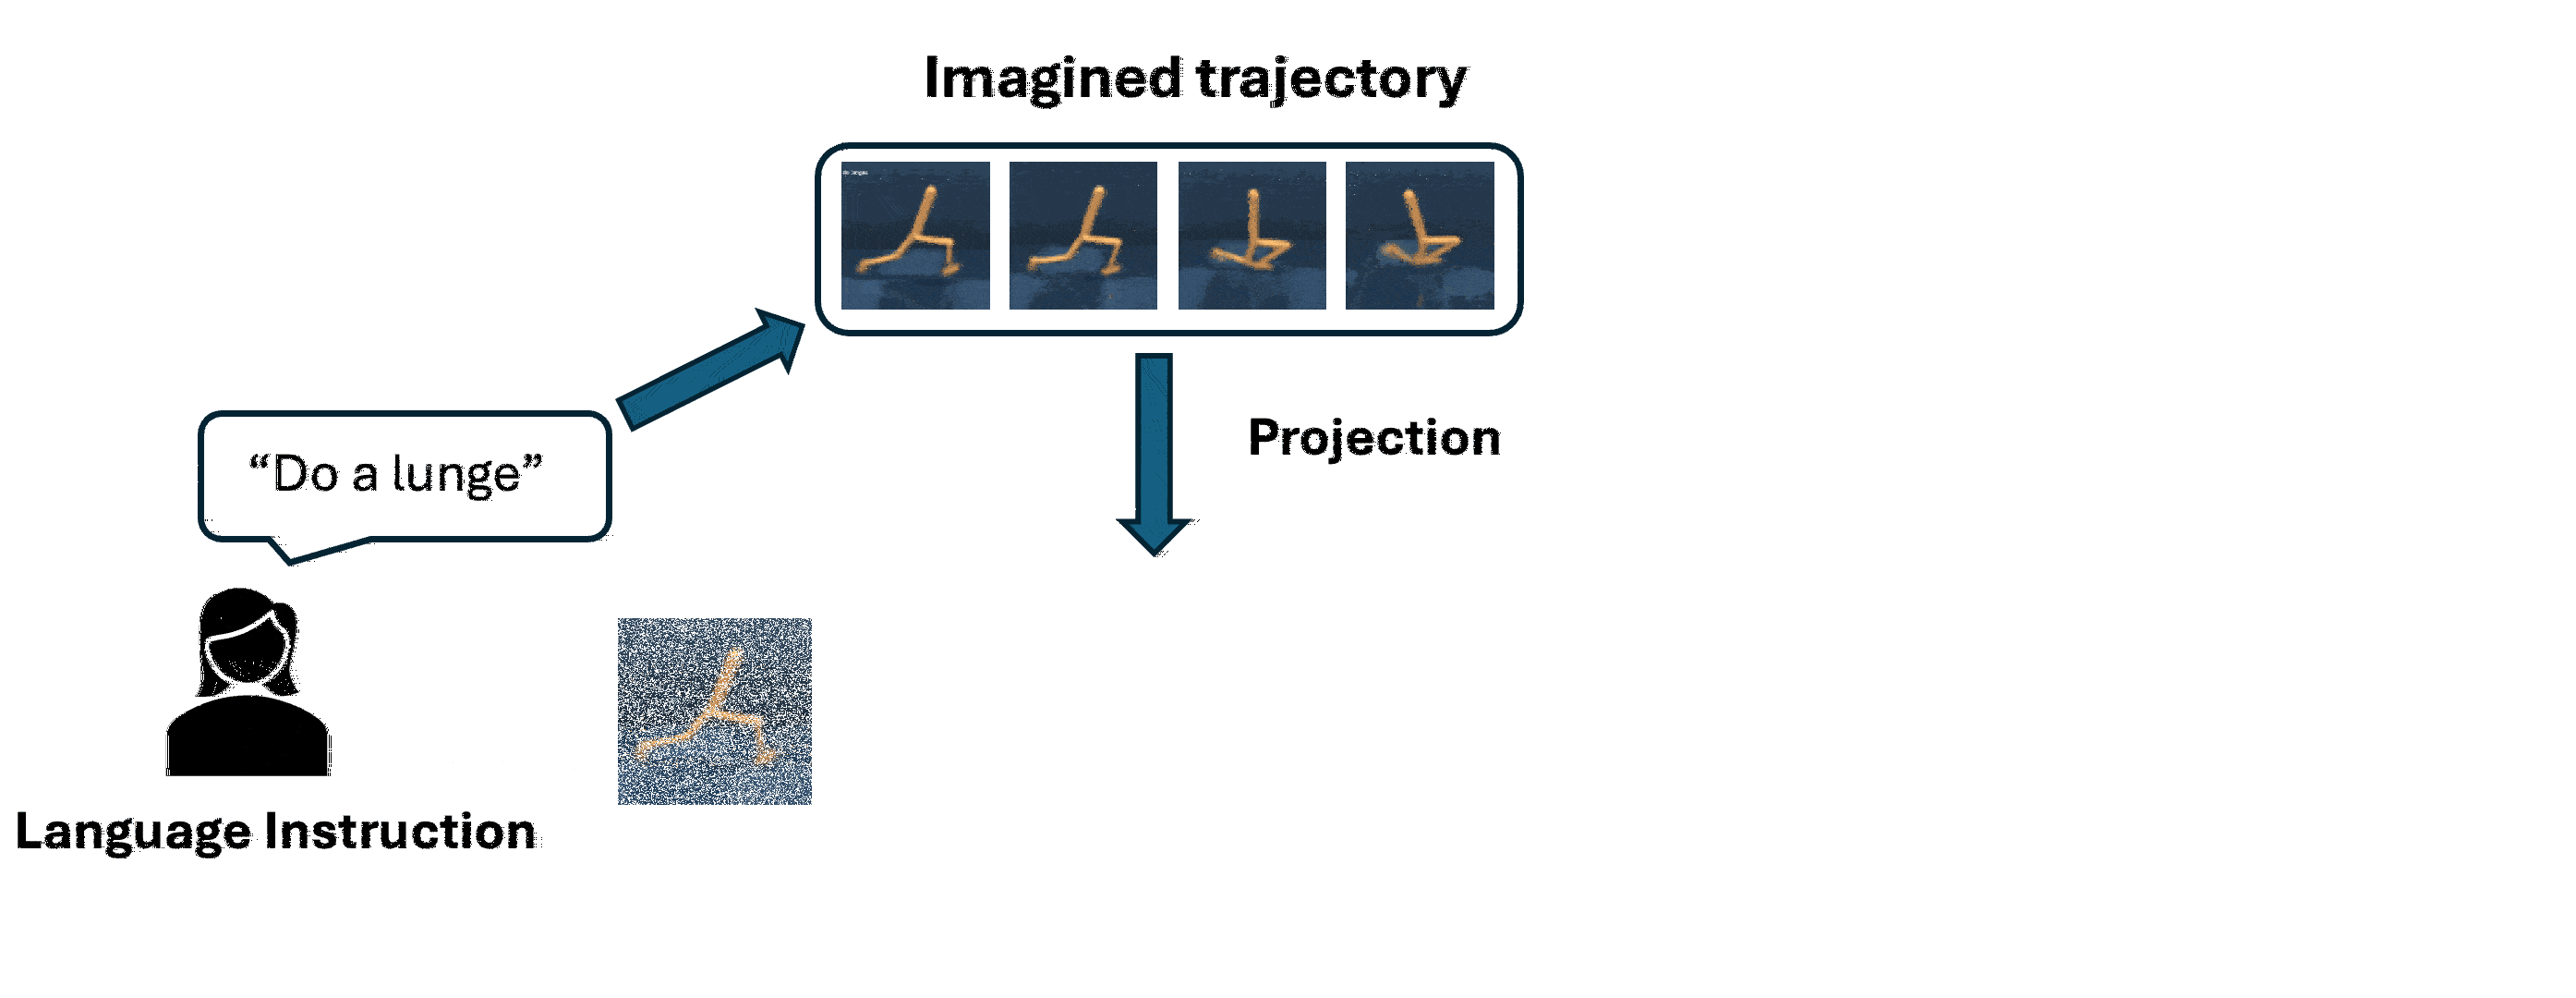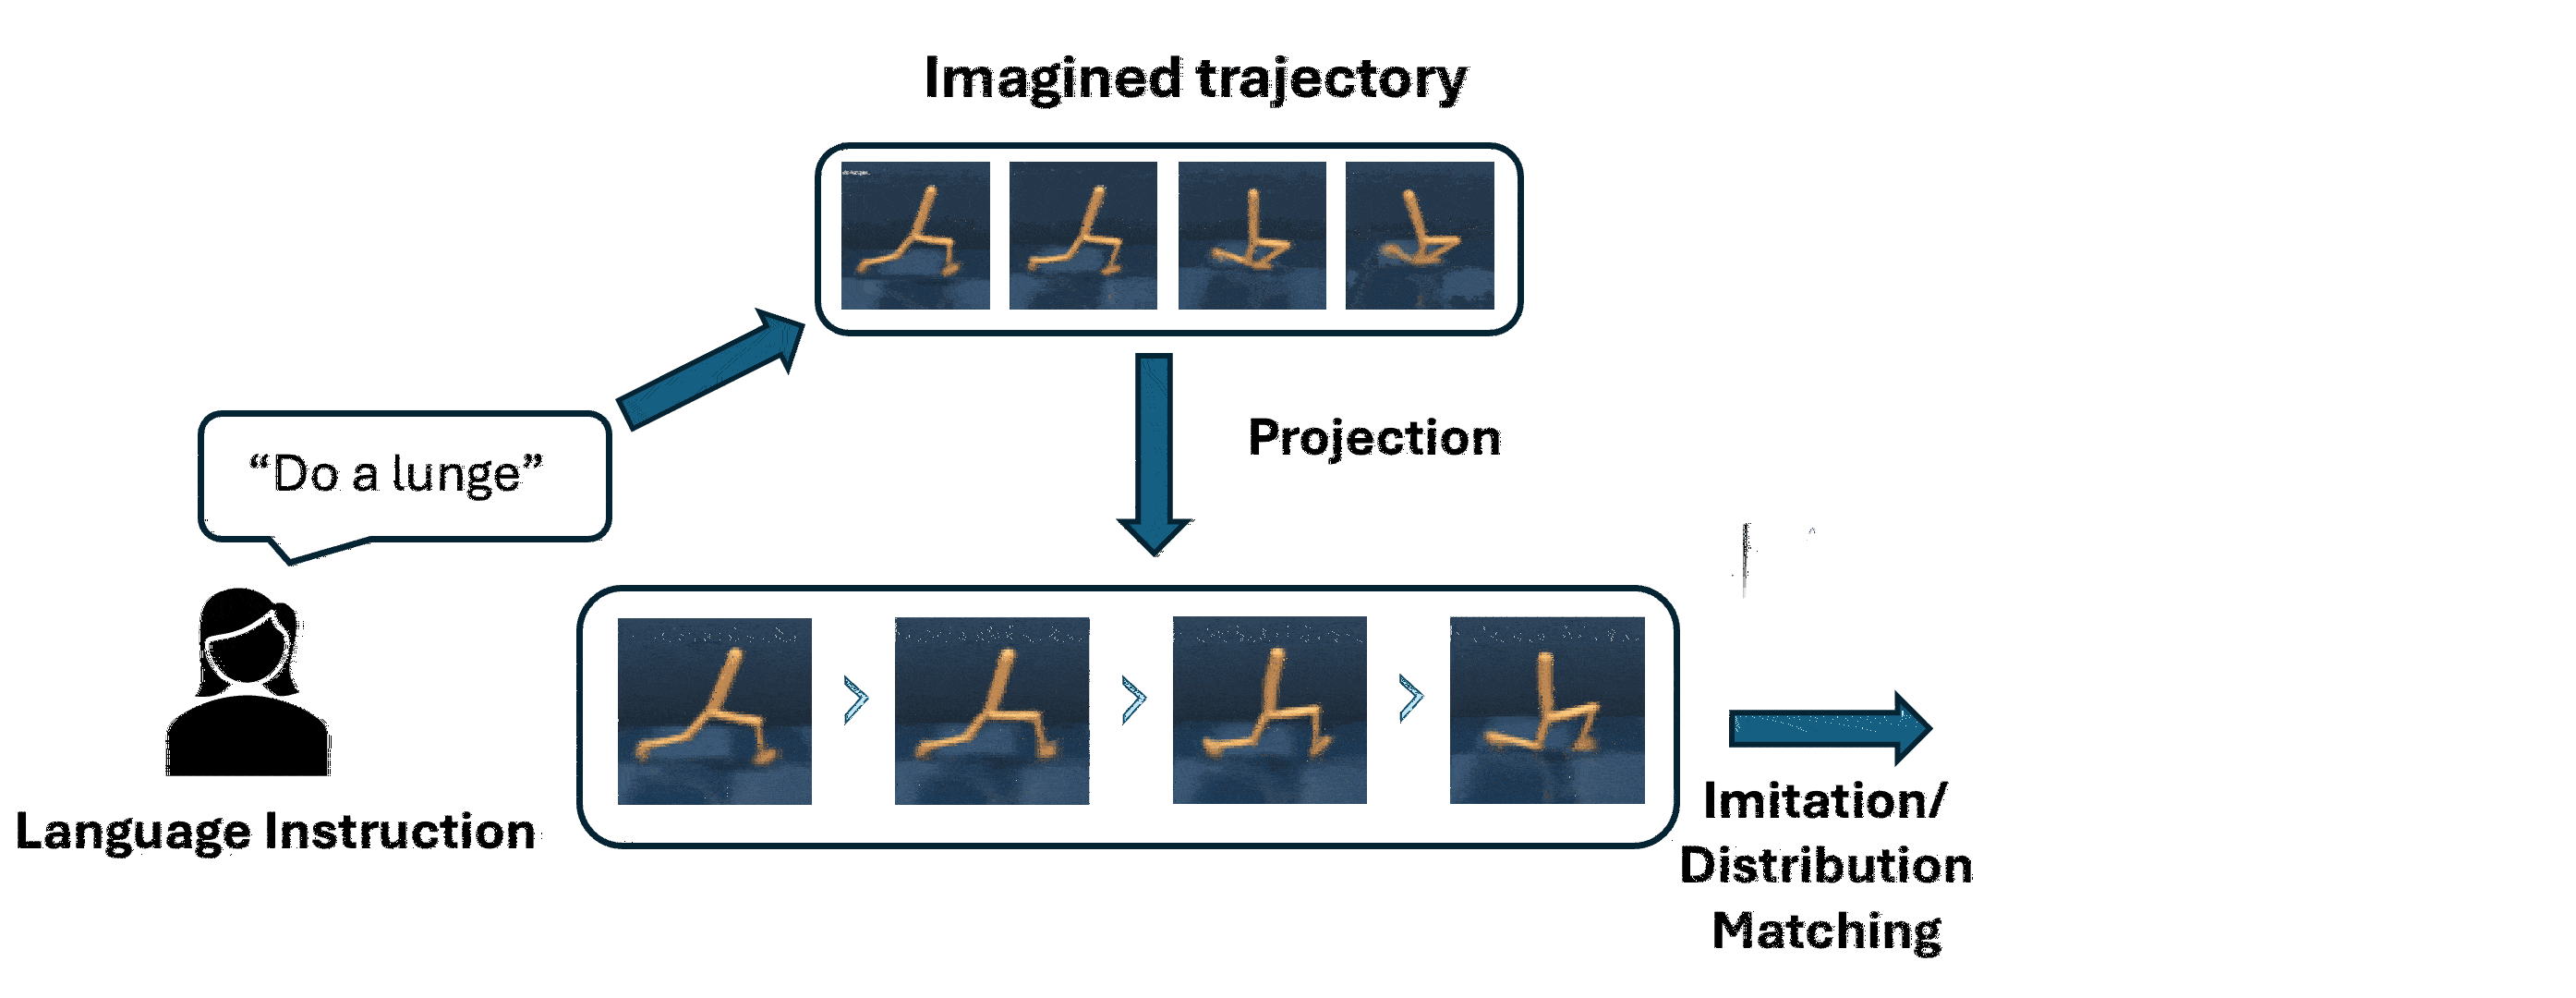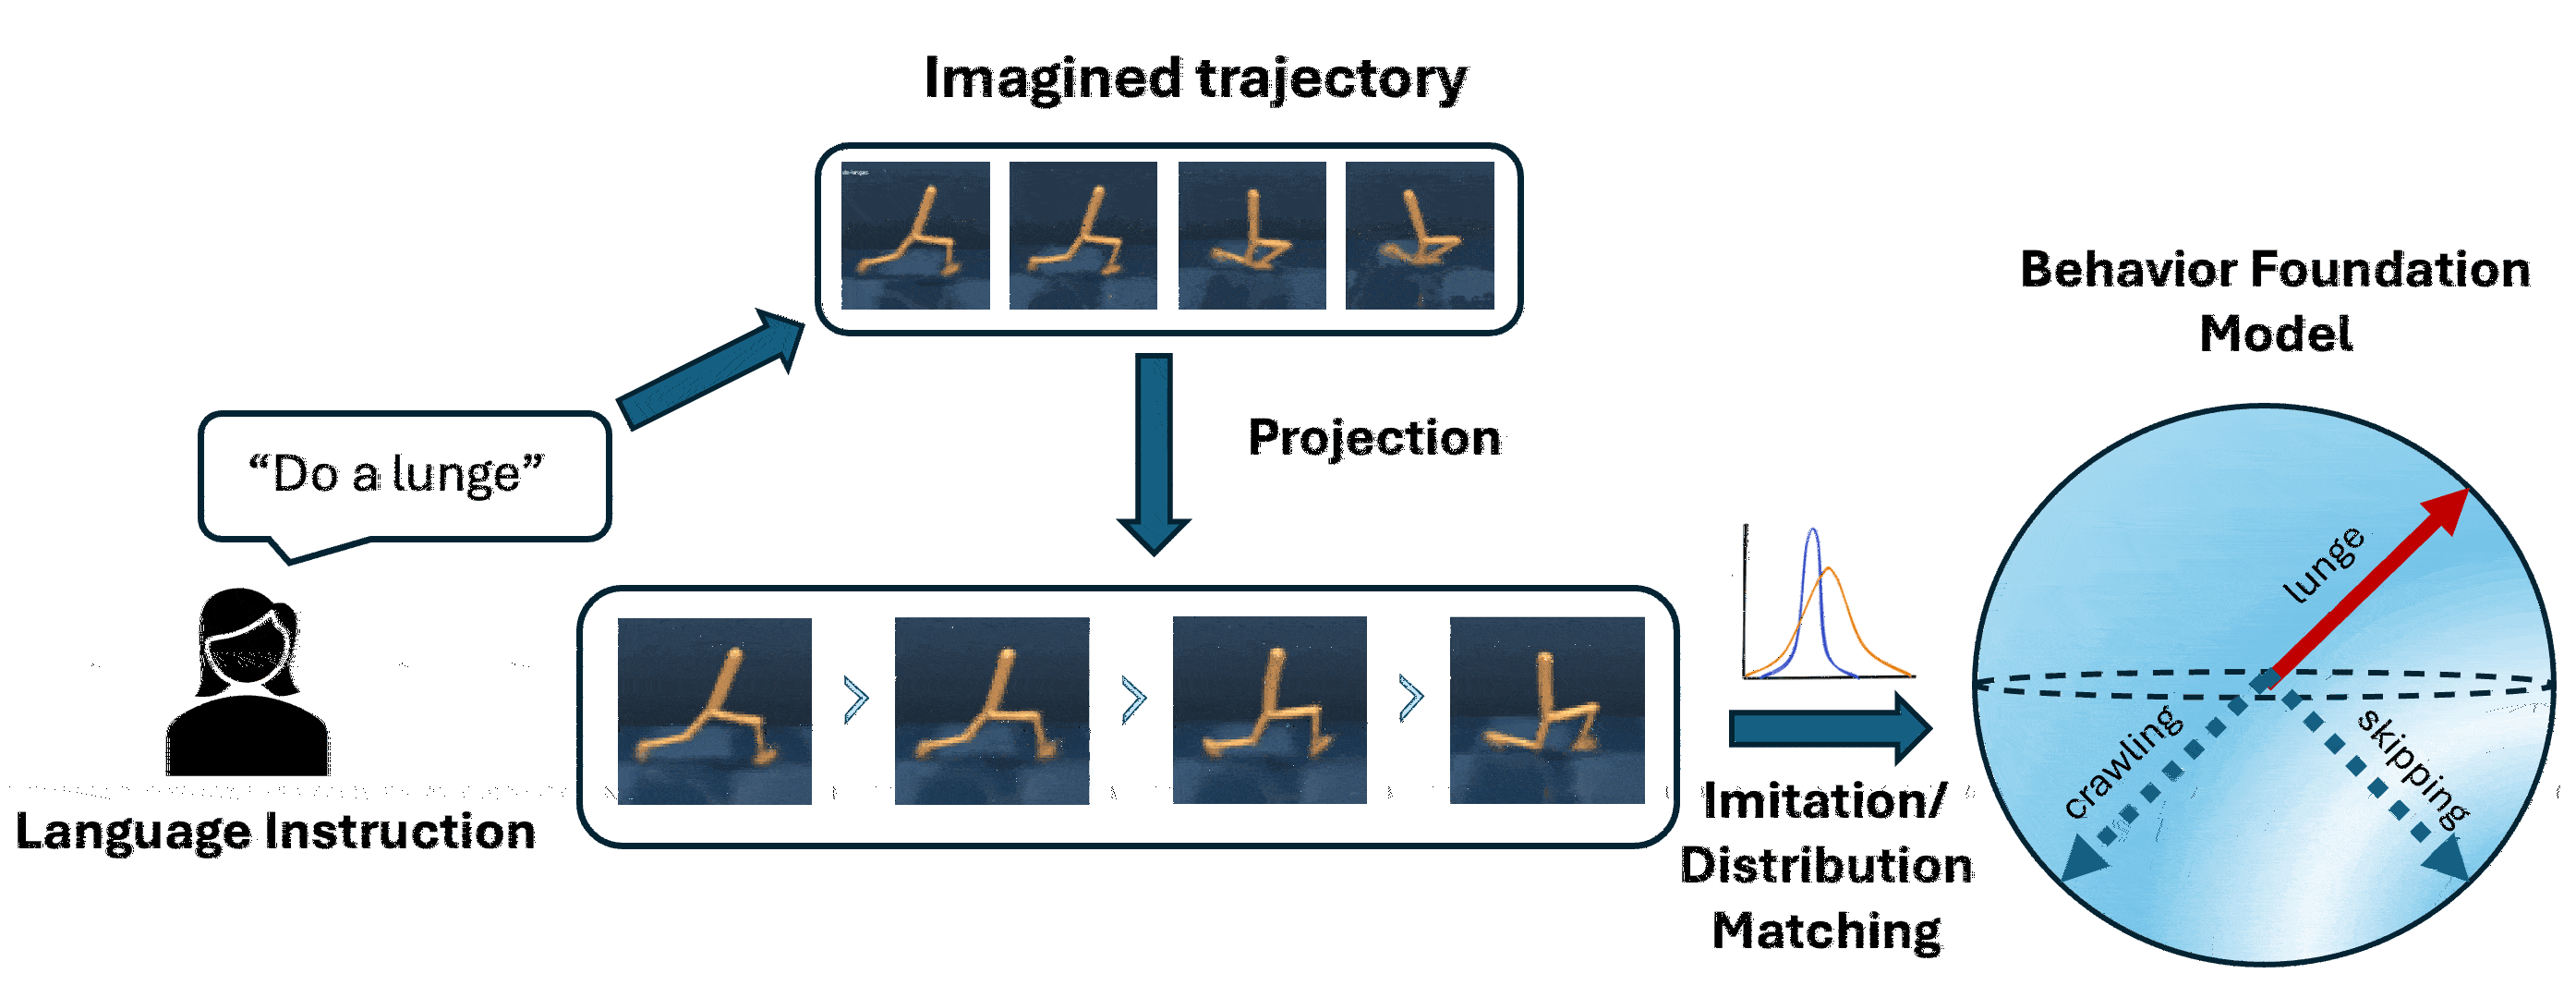
 RL Zero: Zero-Shot Language to Behaviors without any Supervision
Harshit Sikchi, Siddhant Agarwal, Pranaya Jajoo, Samyak Parajuli, Caleb Chuck, Max Rudolph, Peter Stone, Amy Zhang, Scott Niekum
ICLR 2025 Robot Learning Workshop
|
arXiv
|
project page
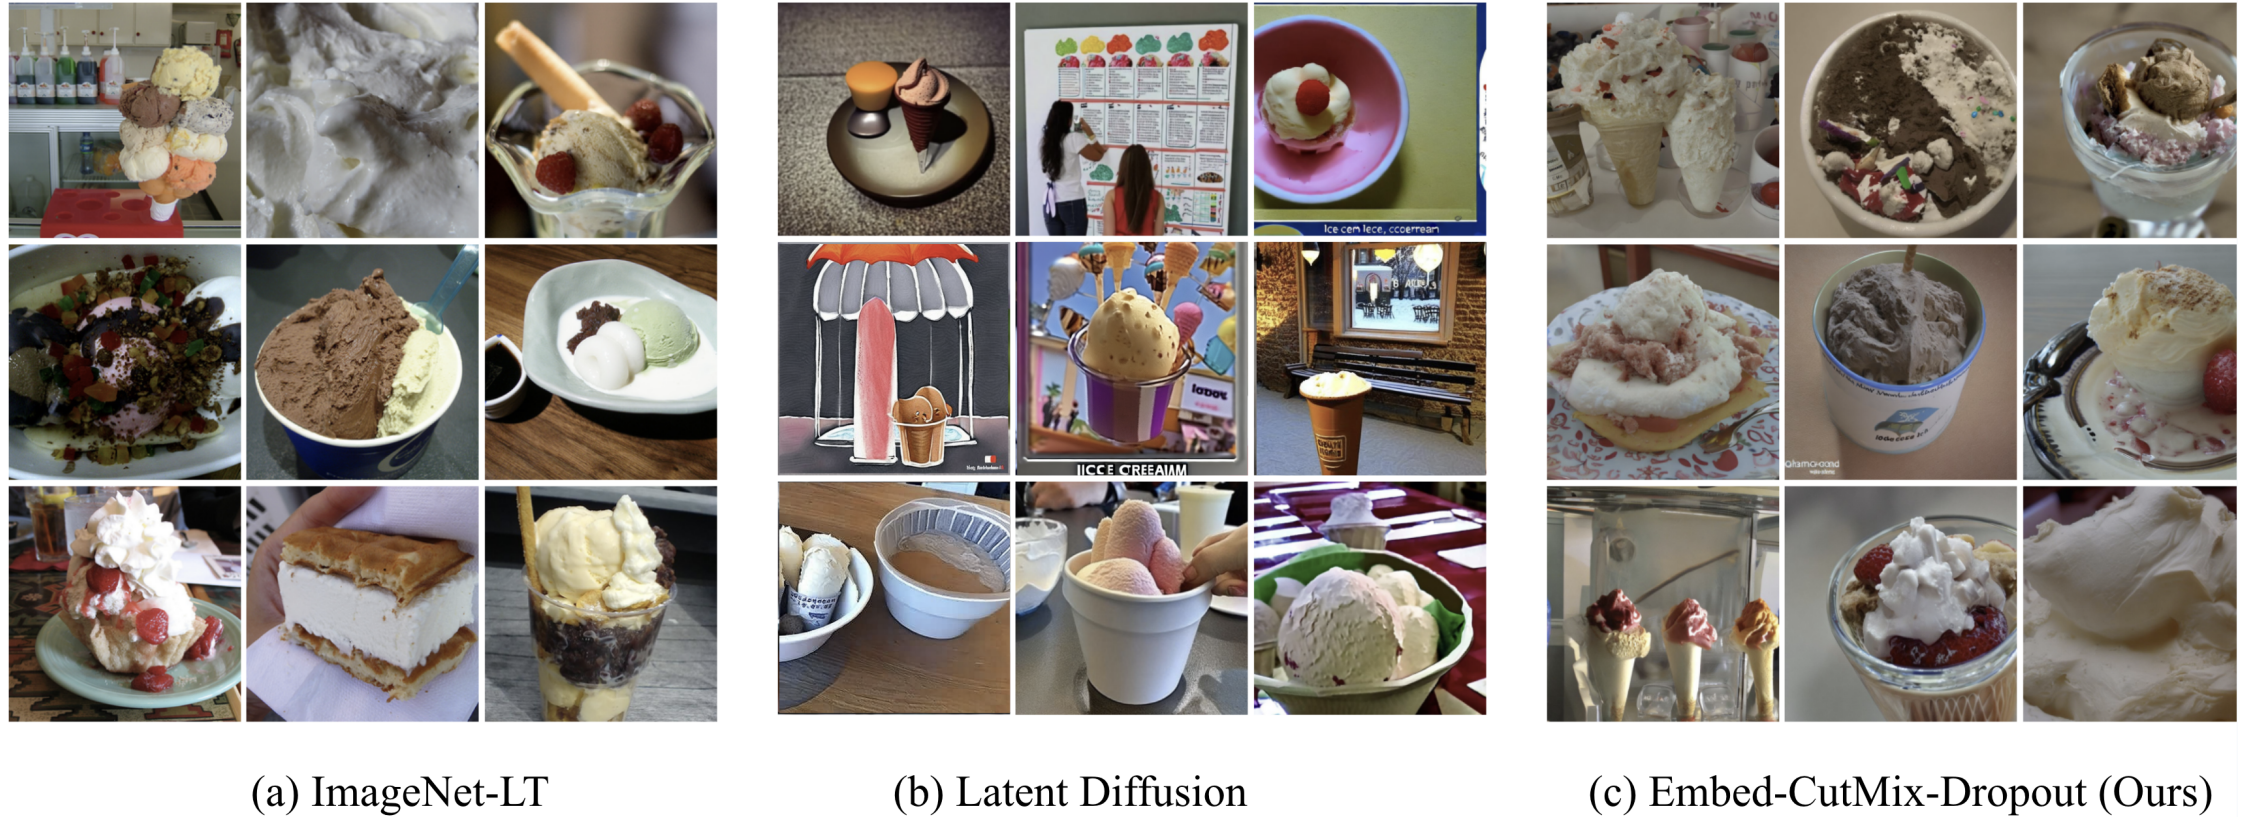
 Augmented Conditioning Is Enough For Effective Training Image Generation
Jiahui Chen, Amy Zhang, Adriana Romero-Soriano
ICLR 2025 SynthData Workshop
|
arXiv
2024
Multistep Inverse Is Not All You Need
Alexander Levine, Peter Stone, Amy Zhang
RLC 2024
|
code
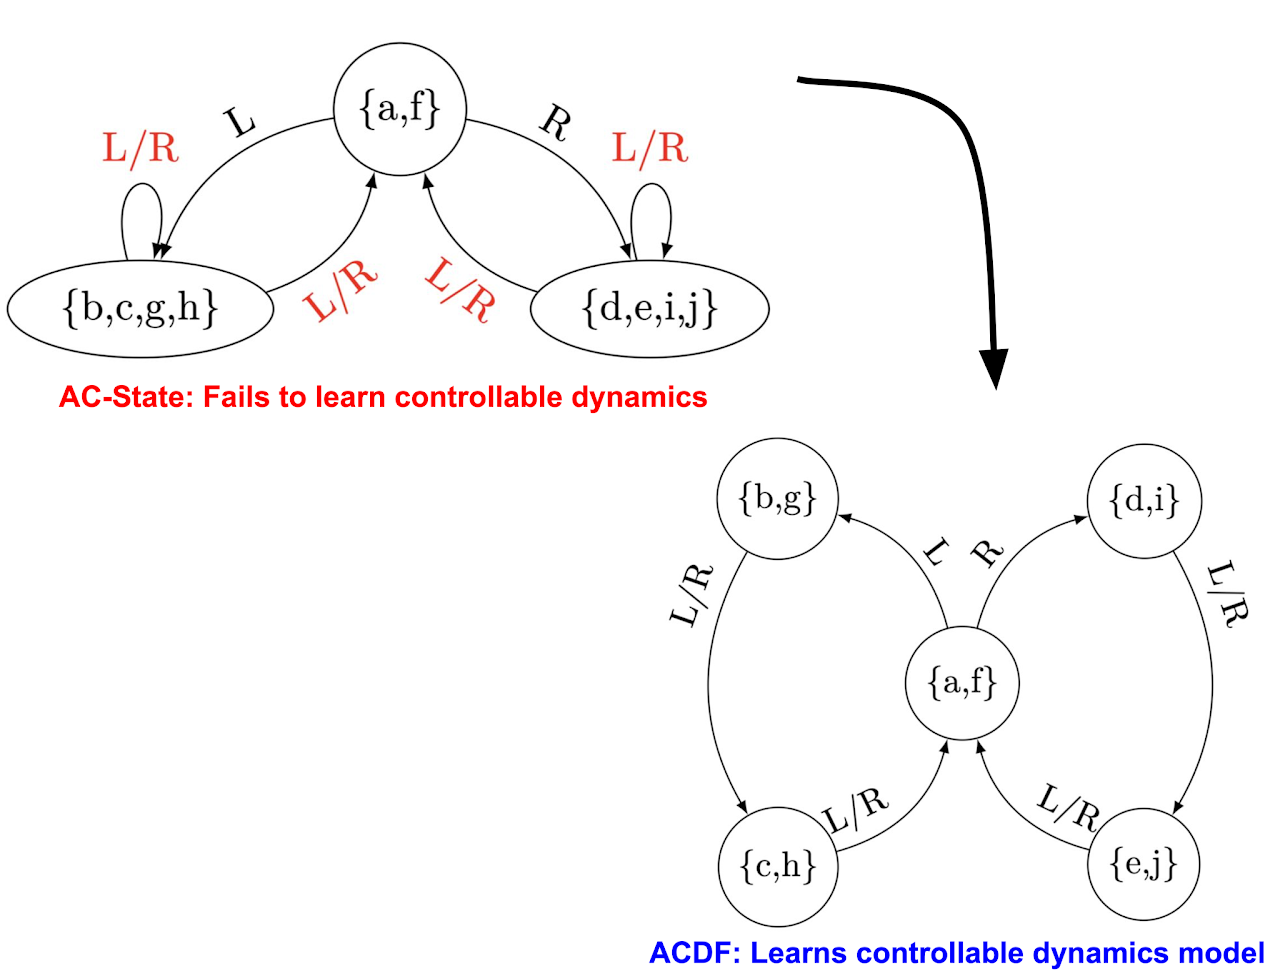 Learning Action-based Representations Using Invariance
Max Rudolph, Caleb Chuck, Kevin Black, Misha Lvovsky, Scott Niekum, Amy Zhang
RLC 2024
|
project page
A Dual Approach to Imitation Learning from Observations with Offline Datasets
Harshit Sikchi, Caleb Chuck, Amy Zhang, Scott Niekum
CoRL 2024
|
project page
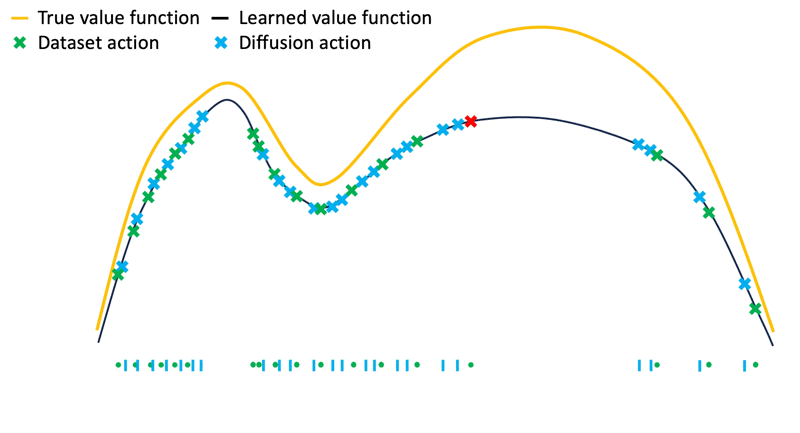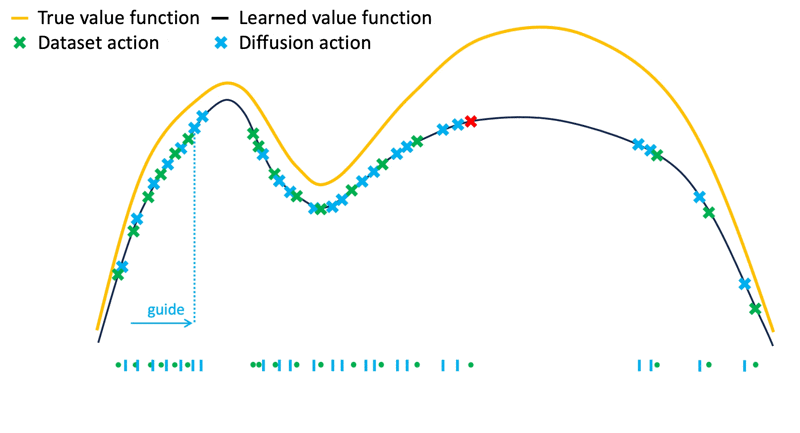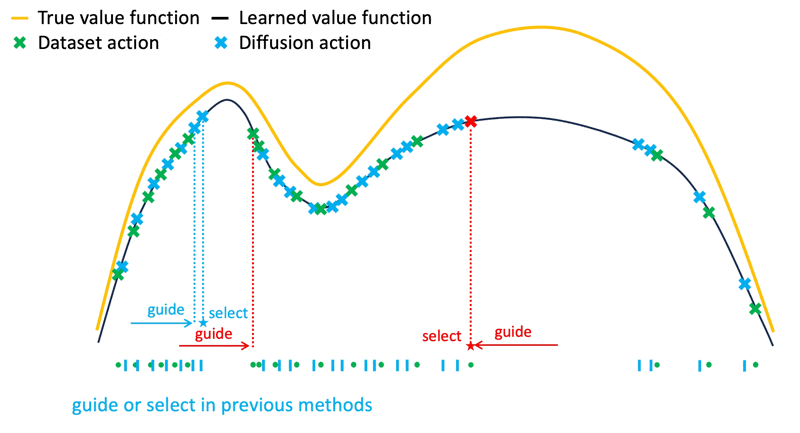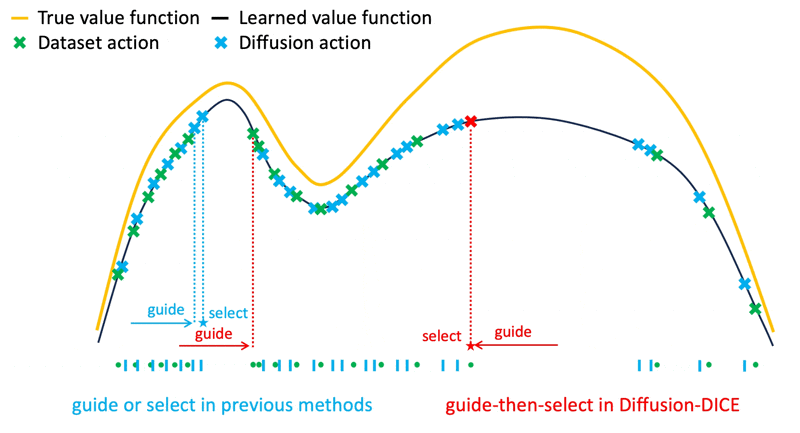
Diffusion-DICE: In-Sample Diffusion Guidance for Offline Reinforcement Learning
Liyuan Mao*, Haoran Xu*, Weinan Zhang, Xianyuan Zhan, Amy Zhang
NeurIPS 2024
|
project page
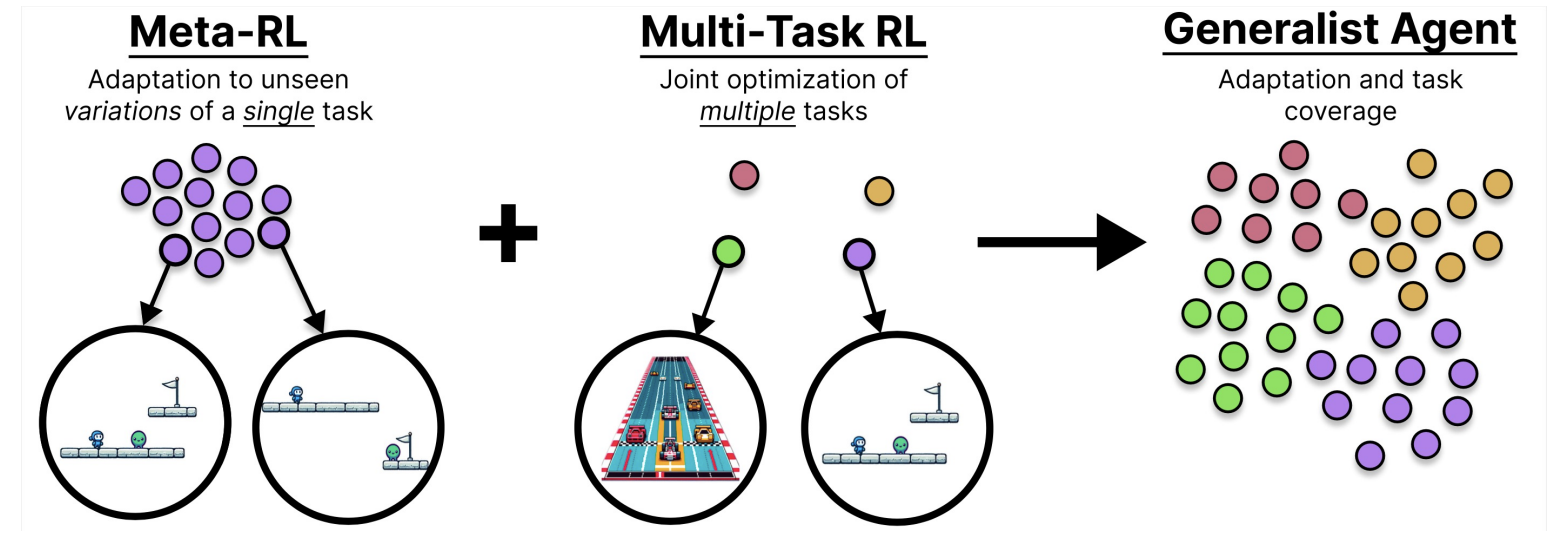
 AMAGO-2: Breaking the Multi-Task Barrier in Meta-Reinforcement Learning with Transformers
Jake Grigsby, Justin Sasek, Samyak Parajuli, Daniel Adebi, Amy Zhang, Yuke Zhu
NeurIPS 2024
|
project page
 SkiLD: Unsupervised Skill Discovery Guided by Factor Interactions
Zizhao Wang, Jiaheng Hu, Caleb Chuck, Stephen Chen, Roberto Martín-Martín, Amy Zhang, Scott Niekum, Peter Stone
NeurIPS 2024
|
project page
Score Models for Offline Goal-Conditioned Reinforcement Learning
Harshit Sikchi, Rohan Chitnis, Ahmed Touati, Alborz Geramifard, Amy Zhang, Scott Niekum
ICLR 2024
|
project page
Dual RL: Unification and New Methods for Reinforcement and Imitation Learning
Harshit Sikchi, Qinqing Zheng, Amy Zhang, Scott Niekum
ICLR 2024
|
project page
Robot Air Hockey: A Manipulation Testbed for Robot Learning with Reinforcement Learning
Caleb Chuck, Carl Qi, Michael J. Munje, Shuozhe Li, Max Rudolph, Chang Shi, Siddhant Agarwal, Harshit Sikchi, Abhinav Peri, Sarthak Dayal, Evan Kuo, Kavan Mehta, Anthony Wang, Peter Stone, Amy Zhang, Scott Niekum
ICRA 2024 Workshop on Manipulation Skills
|
arXiv
|
project page
Automated Discovery of Functional Actual Causes in Complex Environments
Caleb Chuck, Sankaran Vaidyanathan, Stephen Giguere, Amy Zhang, David Jensen, Scott Niekum
arXiv
|
project page
2023
f-Policy Gradients: A General Framework for Goal Conditioned RL using f-Divergences
Siddhant Agarwal, Ishan Durugkar, Peter Stone, Amy Zhang
NeurIPS 2023
|
arXiv
|
project page